创意团队经常需要组合多份参考素材、保持主体或产品一致,并在不从头重做图像的情况下更新文字。Qwen-Image-Edit-Plus(亦以 Qwen-Image-Edit-2509 发布)将这些任务整合到一套基于提示词的工作流中。
这款基于 Qwen-Image 构建的 20B MMDiT 模型,面向需要更精细控制多图合成与局部编辑的营销人员、设计师、电商团队和内容创作者。
为什么选择 Qwen-Image-Edit-Plus
图像生成适合探索创意,但生产工作更依赖可重复性:每次修改都必须保留正确的人物、产品、版式和文字。Qwen-Image-Edit-Plus 专注于可控的高保真编辑,让团队在迭代时不丢失已有的有效元素。
主要优势
- 修改更精准: 无论局部调整还是整体转换,都能让提示词聚焦于目标变化。
- 双语文字编辑: 可修改中英文文案,以及字体、颜色和材质属性。
- 一致性更强: 在新姿势、风格、场景和营销素材中保持人物与产品的辨识度。
核心能力
- 多图编辑: 组合人物 + 人物、人物 + 产品或人物 + 场景等参考素材。为获得最佳效果,建议使用一至三张输入图像。
- 人物一致性: 在不同人像风格和姿势转换中保持面部身份特征。
- 产品一致性: 在制作海报、产品植入和营销变体时保留产品特征。
- 文字一致性: 在保留周围设计的同时,修改文案以及字体、颜色和材质。
选择合适的编辑模式
该模型的一项重要创新,是采用两种不同层级的图像编辑方式。
-
外观级编辑(Appearance-Level Editing):适合精细、底层的局部修改,可以理解为专业级图像修补。目标是在完全不影响图像其他区域的情况下完成指定变化,非常适合移除物体、添加新元素或修正瑕疵。
-
语义级编辑(Semantic-Level Editing):适合高层次的创意转换。只要保留图像的核心含义与内容,模型就可以更广泛地改变像素。它非常适合风格迁移、物体旋转或IP 创作等输出风格不同、但语义与原图一致的任务。
多图工作流如何运作
Qwen-Image-Edit-Plus 的优势在于直观的提示词界面。下面以实际示例说明它能完成什么,以及应如何编写提示词。
示例:根据三张参考图合成图像
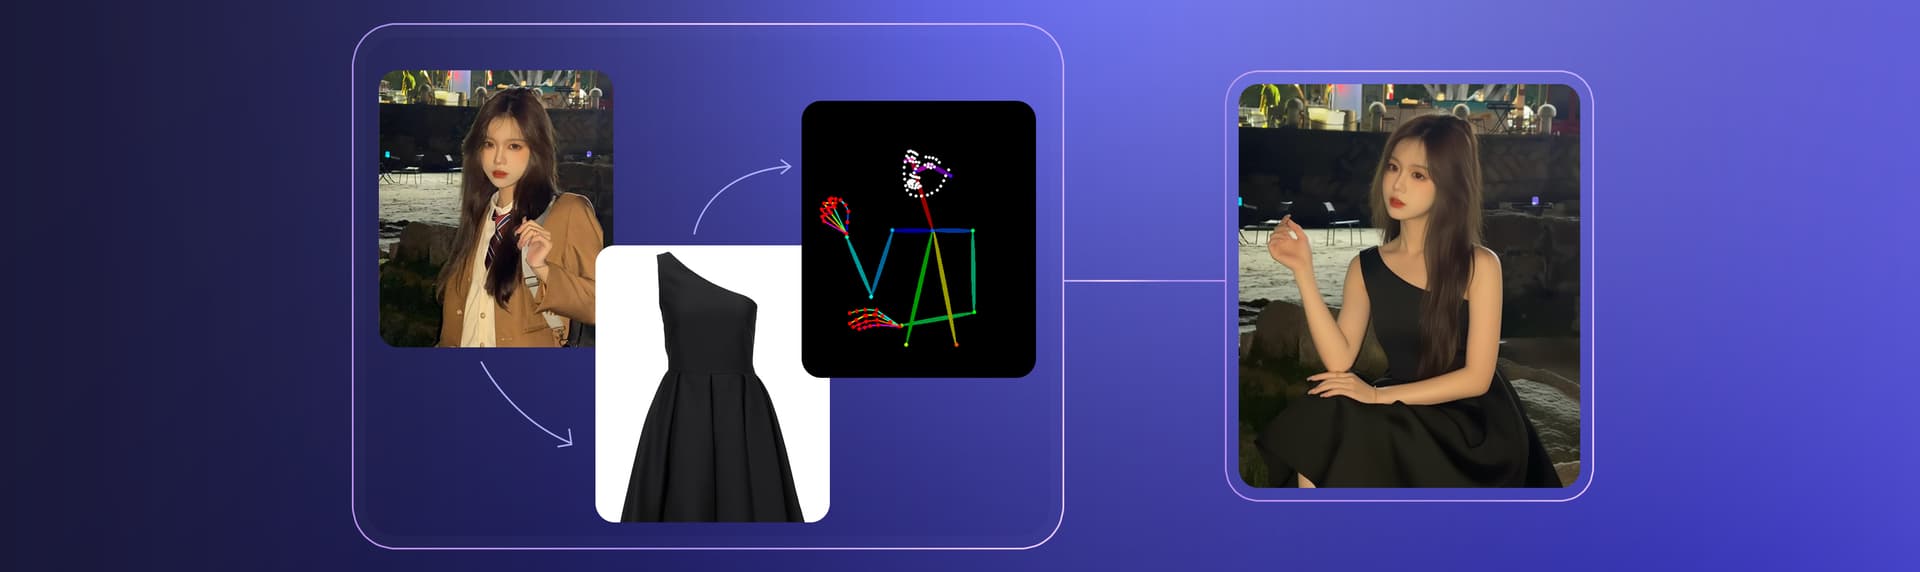
目标: 将三张独立参考图中的人物、连衣裙和姿势组合成一张时尚图片。
- 上传参考图:
- 图像 1:女孩的肖像。
- 图像 2:黑色连衣裙的照片。
- 图像 3:模特摆出特定姿势的图片。
- 描述组合方式:
In the style of a fashion photo, create an image of the girl from Image 1, wearing the black dress from Image 2, and in the pose from Image 3.
从目标明确的编辑开始
先确定一个清晰目标,并准备一至三张质量可靠的参考图。明确指出哪些元素需要改变、哪些必须保持不变,以及期望的视觉结果。构图正确后,再分步骤细化文字、颜色、光照或材质。